Artykuł sponsorowany
Dlaczego surowy plik z nagrania lektorskiego wymaga czyszczenia, korekcji i masteringu
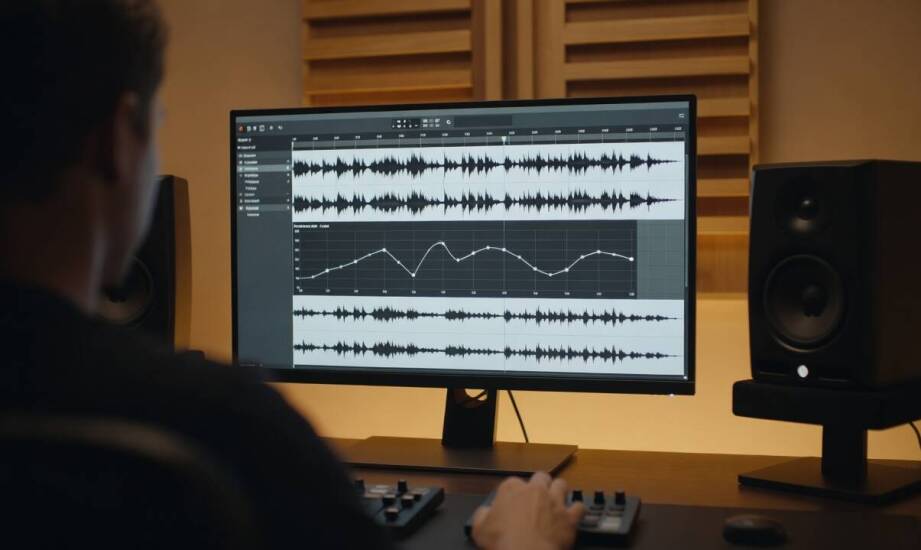
Surowy plik z nagrania lektorskiego rejestruje autentyczny głos z sesji, ale w tej formie rzadko nadaje się do bezpośredniej publikacji. Mikrofon studyjny zbiera każdy detal akustyczny, co w praktyce oznacza rejestrację nie tylko samej narracji, ale też wszelkich niedoskonałości otoczenia i aparatu mowy. Zanim materiał trafi do kampanii reklamowej, centrali telefonicznej czy modułu szkoleniowego, wymaga wieloetapowej obróbki dźwiękowej. Profesjonalna postprodukcja zamienia zbiór surowych ujęć w spójny format, który podkreśla przekaz i utrzymuje uwagę słuchacza bez technicznych rozpraszaczy.
Dlaczego surowy materiał z sesji wymaga edycji?
Nawet najlepiej zaadaptowana akustycznie kabina nagraniowa i topowej klasy mikrofon nie eliminują całkowicie biologicznych aspektów ludzkiej mowy. W pliku dźwiękowym pozostają głębokie oddechy między frazami, kliknięcia z ruchu warg, a także minimalny, ale wciąż słyszalny szum tła. Nierówne pauzy i różnice w głośności poszczególnych zdań skutecznie utrudniają odbiór dłuższego tekstu informacyjnego. Mikrofon kondensatorowy mocno uwydatnia również sybilanty, czyli ostre, syczące dźwięki powstające przy wymowie liter takich jak „s” czy „c”.
Pierwszym krokiem po zakończeniu pracy lektora jest wnikliwa selekcja dubli. Realizator przesłuchuje cały materiał, wybiera najlepsze intonacyjnie ujęcia i łączy je w jedną, spójną oś czasu. Precyzyjne cięcia usuwają niepożądane odgłosy, kliknięcia języka i zbyt długie pauzy bez naruszania naturalnego rytmu wypowiedzi. Technik dba o to, by odstępy między zdaniami brzmiały autentycznie, imitując płynną, nieprzerywaną mowę. Dopiero zmontowana w ten sposób ścieżka trafia do właściwej obróbki barwowej oraz korekcji dynamiki.
Korekcja częstotliwościowa polega na usunięciu rezonansów oraz kształtowaniu ogólnego brzmienia. Inżynier dźwięku podkreśla pasma odpowiedzialne za wyrazistość głosu i tłumi częstotliwości powodujące efekt dudnienia. Następnie do pracy wkracza de-esser, który punktowo redukuje nadmiar sybilantów, chroniąc przed nieprzyjemnym kłuciem w uszach przy głośnym słuchaniu. Ostatnim technicznym etapem jest zastosowanie kompresora. Narzędzie to wyrównuje dynamikę nagrania, podnosząc ciche detale i obniżając zbyt głośne piki na wykresie fali. Dzięki temu narrator brzmi stabilnie i blisko odbiorcy, niezależnie od tego, czy zniża głos, czy akcentuje ważną frazę.
Specyfika obróbki dla IVR, filmu i e-learningu
Każdy kanał dystrybucji narzuca inne wymagania techniczne dla docelowego pliku audio. Nagrania do central telefonicznych wymagają maksymalnej czytelności w bardzo wąskim paśmie. Systemy IVR często kompresują dane do formatów ośmiobitowych o niskim próbkowaniu. Equalizacja w takich przypadkach musi radykalnie odciąć najniższe i najwyższe tony, by komunikat pozostał zrozumiały w słuchawce telefonu, nie generując niepotrzebnych przesterów.
Produkcja warstwy głosowej do filmów wideo, dokumentów oraz animacji kieruje się zupełnie innymi prawami. Tutaj priorytetem staje się precyzyjna synchronizacja z obrazem oraz płynna integracja z podkładem muzycznym i sound designem. Głos lektora musi naturalnie osadzić się w miksie, zostawiając wystarczającą przestrzeń na pozostałe elementy dźwiękowe. Często stosuje się w tym wypadku delikatniejsze ustawienia dynamiki, aby zachować filmową głębię i autentyczność ludzkich emocji.
Materiały e-learningowe oraz zaawansowane szkolenia to formaty nastawione na długi, nieprzerwany czas słuchania. Wymagają one idealnej spójności barwy i głośności pomiędzy dziesiątkami modułów nagrywanymi nierzadko podczas różnych sesji. Korekcja uwzględnia tu specyfikę stratnej kompresji do formatu MP3 z niską przepływnością, zapobiegając zniekształceniom na wyższych częstotliwościach.
Ostatnim krokiem przed eksportem pliku jest rygorystyczna kontrola głośności, określana jako loudness, oraz ustawienie parametrów limitera. Materiały przeznaczone do tradycyjnego broadcastu w telewizji i radiu muszą bezwzględnie trzymać się normy -23 LUFS określonej przez organizację EBU. W internecie i usługach streamingowych zasady ulegają zmianie. Serwis Spotify podaje rekomendację na poziomie -14 LUFS z odpowiednim zapasem dla wartości True Peak. Z kolei platforma YouTube opiera się na algorytmach normalizujących, które stabilizują poziom dźwięku bez narzucania twórcom jednego, sztywnego progu docelowego.
Cały łańcuch obróbki decyduje o ostatecznym brzmieniu i jakości zrealizowanego materiału głosowego. Żaden pojedynczy zabieg na końcu procesu nie ukryje błędów popełnionych na etapie selekcji ujęć czy wycinania oddechów. Dopiero konsekwentna edycja, właściwa equalizacja i świadomy mastering gwarantują, że dźwięk spełni standardy techniczne wybranego medium dystrybucji.
Właściwe przygotowanie plików audio wymaga zaplecza technicznego oraz wieloletniego doświadczenia w pracy z różnorodnym materiałem wejściowym. Działające od 2004 roku studio Lektoring.pl zajmuje się kompleksową realizacją i postprodukcją dźwięku dla klientów biznesowych oraz instytucji. Firma prowadzi rozbudowany bank głosów, w którym znajdują się wyselekcjonowane glosy lektorów z Polski i zagranicy. Takie zasoby pozwalają na optymalne dopasowanie charakteru brzmienia do specyfiki lokalnych kampanii reklamowych, wielojęzycznych systemów IVR czy rozbudowanych szkoleń e-learningowych.
Kategorie artykułów
Polecane artykuły

Skoki tandemowe: co warto wiedzieć o bezpieczeństwie i certyfikatach dla instruktorów?
Skoki tandemowe to fascynująca forma skoków spadochronowych, w której doświadczony instruktor jest połączony z uczestnikiem za pomocą specjalnej uprzęży. Cały proces rozpoczyna się od krótkiego szkolenia teoretycznego, a następnie następuje lot samolotem i skok z wysokości około 4000 metrów. Korzyśc

Efektywne zarządzanie flotą dzięki integracji systemów do wyznaczania tras.
Efektywne zarządzanie flotą pojazdów odgrywa istotną rolę w branży transportowej, zwłaszcza z zastosowaniem nowoczesnych systemów do wyznaczania trasy przez kilka punktów w Google Maps. Integracja tych rozwiązań prowadzi do zwiększenia efektywności operacyjnej oraz redukcji kosztów. W artykule przyj